


Gepubliceerd: 30 april 2026
Met ingebouwde AI kan je website of web-app AI-gestuurde taken uitvoeren zonder dat je modellen hoeft te implementeren, te beheren of zelf te hosten. Het kan een uitdaging zijn om van een demo naar een productierijpe functie te gaan. In dit document worden technische en UX-overwegingen behandeld om veelvoorkomende valkuilen te vermijden.
De meeste richtlijnen zijn van toepassing op alle ingebouwde AI-API's. Uitzonderingen worden vermeld.
Het model op een redelijke tijd voorbereiden
Doen: Initialiseer de sessie zodra je duidelijk hebt vastgesteld dat de gebruiker de AI-functie wil gebruiken, bijvoorbeeld als een gebruiker naar een relevant AI-toolgebied navigeert, de cursor op een AI-werkruimte plaatst of interactie heeft met de UI rond de functie. Door de sessie vooraf op te warmen, kan het model op de achtergrond in het geheugen worden geladen terwijl de gebruiker de taak instelt. Zo wordt vermijdbare vertraging bij een koude start voorkomen. Probeer een stap voor te blijven door de volgende meest waarschijnlijke AI-taak te starten zodra je het huidige resultaat begint te renderen, bijvoorbeeld als de functie is ontworpen voor iteratief gebruik.
Niet doen: Wacht niet tot de gebruiker op Genereren klikt om de sessie te initialiseren, tenzij dit nodig is. Dit leidt tot een vertraging bij de cold start, omdat het model eerst in het geheugen moet worden geladen en de uitvoeringspipeline moet worden voorbereid.
Eerste prompts instellen tijdens het maken
De volgende richtlijnen zijn van toepassing op de Prompt API.
Doen: Systeeminstructies geven tijdens de initialisatie van de sessie om de snelheid van de eerste prompt te verbeteren.
Niet doen: Begin met een lege sessie en stuur systeeminstructies als onderdeel van de eerste prompt()-aanroep. Dit verhoogt de latentie omdat het model gedwongen wordt om
die instructies op het laatste moment te verwerken.
// ✅ DO: Create the session as early as possible (warm up the model early) and
// use initialPrompts for system instructions in the create call
const session = await LanguageModel.create({
  initialPrompts: [
    {
      role: 'system',
      content: 'You are a helpful assistant specialized in code reviews.'
    }
  ]
});

// Once the user triggers the AI feature
const review = await session.prompt(`Review the following code:\n\n${code}`);

// ❌ DON'T: Send instructions using prompt() after creation
// const slowerSession = await LanguageModel.create();
// await slowerSession.prompt(`You are a helpful assistant specialized in code reviews.\n\nReview the following code:\n\n${code}`); // Higher latency
Sessies klonen voor herhaalde taken
De volgende richtlijnen zijn van toepassing op de Prompt API.
Voor de Prompt API houdt elke sessie de context van het gesprek bij, waarbij rekening wordt gehouden met alle eerdere interacties. Omdat een kloon alles overneemt van de bovenliggende sessie, inclusief de eerste prompts en de hele interactiegeschiedenis tot het moment van klonen, moet je je gebruik zo structureren dat je alleen overneemt wat je nodig hebt.
Doen:
- Maak een basissessie: Als je niet-gerelateerde taken efficiënt wilt afhandelen, maak je een basissessie die alleen je systeeminstructies bevat en geen eerdere gesprekscontext.
- Kloon de baseline: Gebruik
clone()voor die basissessie voor nieuwe taken om de overhead van het opnieuw parseren van systeeminstructies te besparen. Zo kun je parallelle gesprekken maken of een taak resetten naar de basislijn.
Niet doen:
- Gebruik dezelfde sessie niet opnieuw voor niet-gerelateerde taken en kloon geen sessies die al onnodige interactiegeschiedenis bevatten. Beide patronen kunnen ervoor zorgen dat niet-gerelateerde eerdere context je huidige taak verstoort.
- Roep
create()niet herhaaldelijk aan met identieke systeeminstructies. Gebruik in plaats daarvan het kloonpatroon om de prestaties te optimaliseren.
// ✅ DO: Create a baseline session and clone it for each new task
const baseSession = await LanguageModel.create({
  initialPrompts: [{
    role: 'system',
    content: 'You are a technical editor...',
  }],
});

// Clone the base session once for the first task
const task1 = await baseSession.clone();
const response1 = await task1.prompt("Review this first draft...");
// ... Repeat the cloning pattern for subsequent independent tasks
// Each task starts fresh from the baseline system instructions

// ❌ DON'T:
// Bad performance pattern: repeated create() calls for identical tasks.
// This forces the model to re-parse instructions every time, increasing latency.
// const sessionA = await LanguageModel.create({ initialPrompts: [...] });
// await sessionA.prompt("Task 1...");
// const sessionB = await LanguageModel.create({ initialPrompts: [...] });
// await sessionB.prompt("Task 2...");
// Bad quality pattern: reusing the same session for unrelated tasks.
// const session = await LanguageModel.create();
// await session.prompt("Analyze this financial report...");
// Unrelated task in the same session:
// await session.prompt("Now write a children's story...");
Ongebruikte sessies vernietigen
Doen: Roep destroy() expliciet aan voor sessies die je niet meer nodig hebt om geheugen vrij te maken als een functie niet meer wordt gebruikt. Als je een kloonpatroon gebruikt, behoud je de basissessie en vernietig je de klonen die je niet meer nodig hebt.
Niet doen: Meerdere grote sessies actief houden. Elke sessie verbruikt geheugen,
wat onnodig gebruik van bronnen veroorzaakt en een probleem kan worden. Sessies
worden op een natuurlijke manier opgeschoond door de garbage collector, maar door destroy()
aan te roepen, komt er sneller geheugen vrij.
// ✅ DO: Use the clone and destroy it immediately after
const clone = await baseSession.clone();
const response = await clone.prompt("Quick task...");
// Free memory right away: destry the clone, keep the baseSession
clone.destroy();
Streamingreacties veilig en efficiënt weergeven
Deze richtlijnen zijn van toepassing op API's met streamingondersteuning (Prompt, Summarizer, Writer, Rewriter en Translator).
Doen: Behandel alle LLM-uitvoer als niet-vertrouwde content. Schoon de volledige gecombineerde uitvoer op, niet alleen delen, omdat schadelijke code kan worden opgesplitst in updates. Gebruik vóór de weergave de Sanitizer API, indien ondersteund. Gebruik een streaming Markdown-parser zoals streaming-markdown om een afname in prestaties te voorkomen.
Niet doen: Stel innerHTML rechtstreeks in bij elke chunkupdate. Dit is traag, vooral bij complexe opmaak zoals syntaxismarkering, en kwetsbaar voor injectie.
import * as smd from "streaming-markdown";
// Set up virtual buffer and Sanitizer API
const sanitizer = new Sanitizer({
  allowElements: ['figure', 'figcaption', 'p', 'br', 'strong', 'em', 'img', 'a'],
  allowAttributes: {
    'loading': ['img'], 'decoding': ['img'], 'src': ['img'], 'href': ['a']
  }
});

// Create an off-screen fragment so the parser doesn't cause flicker
// or trigger XSS in the live DOM during the building process.
const buffer = new DocumentFragment();
const parser = smd.parser_new(buffer);

// Use sanitizer as a gatekeeper / cleaner function so we can combine it with the streaming Markdown parser
function syncSanitized(target, sourceFragment) {
  // .sanitize() returns a fresh, clean DocumentFragment
  const cleanFragment = sanitizer.sanitize(sourceFragment);
  // replaceChildren is the modern high-performance way to swap DOM content
  target.replaceChildren(cleanFragment);
}

// Streaming Logic
// `chunks` keeps track of the raw string (useful for logs/debug)
chunks += chunk;
// Let the parser build the DOM incrementally in the buffer.
// This is high-performance because the buffer is not live
smd.parser_write(parser, chunk);
// Use the Sanitizer API to port the content safely to the container.
syncSanitized(container, buffer);
Invoer optimaliseren voor snelheid
Doen: Geef het model alleen door wat strikt noodzakelijk is. Verwijder alles wat niet relevant is voor de taak. Geef voor grote datasets een kort overzicht en een kleine selectie van relevante items.
Niet doen: Onbewerkte tekst, onnodige metadata, HTML-tags of grote ongefilterde lijsten naar de API's sturen. De vertraging neemt aanzienlijk toe met de invoergrootte, waardoor de AI-functie op veel apparaten defect kan lijken.
// ✅ DO: Send only relevant text
const cleanText = document.querySelector('#article').innerText;
const summary = await Summarizer.summarize(cleanText);

// ❌ DON'T: Send the entire DOM structure
// const dirtyText = document.querySelector('#article').innerHTML;
Gestructureerde uitvoer gebruiken voor voorspelbare resultaten
De volgende richtlijnen zijn van toepassing op de Prompt API.
Doen: Als je wilt dat het model gegevens in een specifieke indeling retourneert, gebruik je
gestructureerde
uitvoer
door een responseConstraint-veld te verstrekken om een JSON-schema te leveren. Dit zorgt ervoor dat de uitvoer voorspelbaar is en voorkomt dat je complexe nabewerking of handmatige parsering nodig hebt.
Niet doen: Vertrouw niet alleen op instructies in natuurlijke taal (zoals 'voer alleen JSON uit'). Modellen kunnen gespreksvulling bevatten die je parser breekt.
// ✅ DO: Use a JSON Schema for predictable results
const schema = {
  type: "object",
  properties: {
    isTopicCats: { type: "boolean" }
  }
};

const result = await session.prompt(`Is this post about cats?\n\n${post}`, {
  responseConstraint: schema,
});
console.log(JSON.parse(result).isTopicCats);
Generatie loskoppelen van lengtebeperkingen
De volgende richtlijnen zijn van toepassing op de Prompt API.
Doen: Laat het model de reactie op een natuurlijke manier genereren en gebruik daarna logica aan de clientzijde om de tekst in te korten zodat deze in je UI past.
Niet doen: Strikte tekenlimieten zoals maxLength: 125 afdwingen met gestructureerde uitvoerschema's. Als de reactie van een model langer is dan de limiet die je hebt ingesteld, kan het model overschakelen naar tokens met een hoge dichtheid, zoals vreemde talen of emoji's, om de betekenis te comprimeren. Dit leidt tot onzinnige uitvoer.
/*  DO: Handle overflow using CSS */
.result {
  overflow: hidden;
  white-space: nowrap;
  text-overflow: ellipsis; /* Displays '…' */
}
// ❌ DON'T: Force length in the prompt
const result = await session.prompt("Write a bio in exactly 50 characters.");
Houd de gebruiker op de hoogte
Doen: Gebruik animaties, visuele aanwijzingen en voortgangsindicatoren om de gebruiker op de hoogte te houden, afhankelijk van de complexiteit en de verwachte duur van de taak. De optimale aanpak is afhankelijk van je use case en de verwachte lengte van de API-uitvoer. Enkele ideeën:
- Streaming voor lange content: Voor samenvattingen of chats maakt streaming standaard een typemachine-effect per token. Dit kan natuurlijk aanvoelen en onmiddellijke feedback geven.
- Niet-streaming voor korte taken (of lange asynchrone taken): Voor korte uitvoer, bijvoorbeeld alt-tekst, kan niet-streaming een meer gepolijste UI maken. Ook is er tijd om de volgende AI-taak speculatief voor te bereiden terwijl de huidige taak wordt gerenderd. Deze aanpak werkt ook voor langere asynchrone of achtergrondtaken. Als de gebruiker niet wordt geblokkeerd door de uitvoer om door te gaan, is er geen dringende noodzaak om de uitvoer te produceren terwijl deze plaatsvindt. Geef in de UI aan dat het proces wordt uitgevoerd.
- Visuele overgangen voor updates: Gebruik animaties, zoals woordvervorming, als je tekst vertaalt of herschrijft.
Niet doen: De UI updaten zonder visuele aanwijzingen.
Sluit aan bij het mentale model van de gebruiker over tijd en werk
Doen: Overweeg een kunstmatige vertraging van 1 of 2 seconden als een reactie bijna onmiddellijk is. Paradoxaal genoeg vinden gebruikers resultaten misschien betrouwbaarder als ze een generatieproces waarnemen dat overeenkomt met de waargenomen moeilijkheidsgraad van de taak. Gebruik animaties om aan te geven dat er een AI-verwerking heeft plaatsgevonden.
Niet doen: Gebruikers verrassen met onmiddellijke UI-vervangingen.
Gebruikers toestaan snel te navigeren en AI-bewerkingen ongedaan te maken
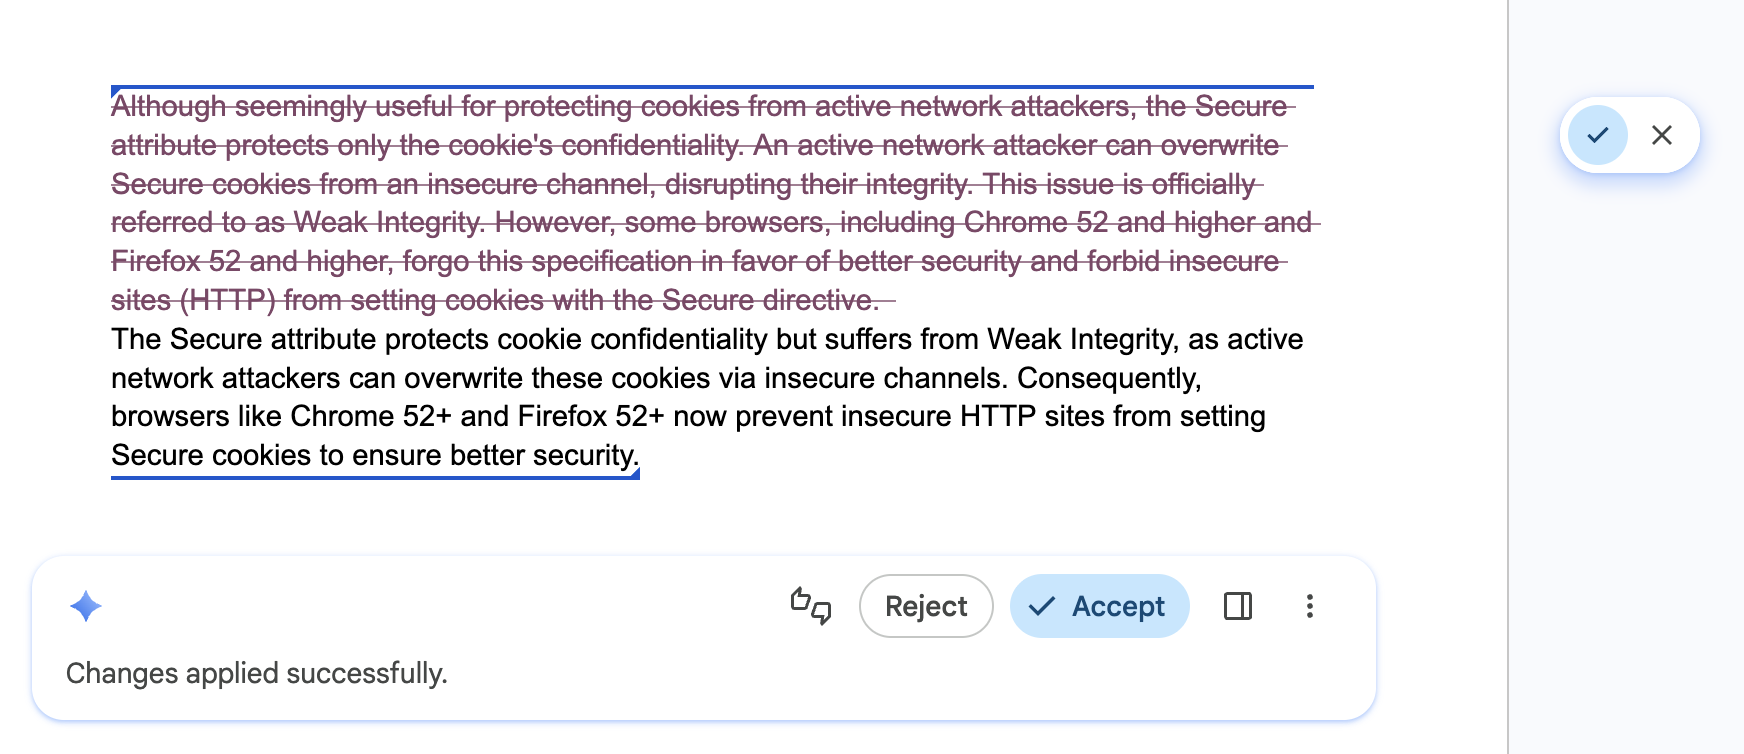
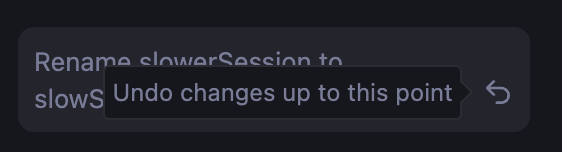
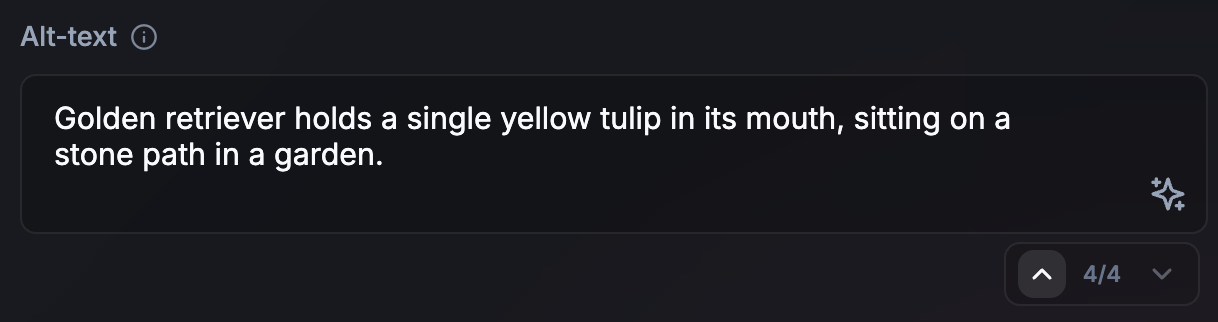
Doen: Voorzie je UI van een stepper of navigatiegeschiedenis waarmee gebruikers met vertrouwen verschillende resultaten kunnen verkennen en AI-bewerkingen snel ongedaan kunnen maken. Zo blijven verschillende versies makkelijk beschikbaar.
Niet doen: Het vorige concept van de gebruiker of een AI-resultaat dat de gebruiker misschien leuk vond, overschrijven zonder een manier om terug te gaan, de wijzigingen ongedaan te maken of versies te vergelijken.
Gebruikerscontrole en overschrijvingen mogelijk maken
Doen: Maak de gebruiker de eindredacteur van alle gegenereerde content. Bied intuïtieve overschrijvingen, zodat de gebruiker de volledige controle houdt over de uiteindelijke uitvoer. De API's kunnen onjuiste resultaten opleveren.
Niet doen: Een AI-gegenereerd resultaat afdwingen als de enige optie.
Resultaten in cache opslaan voor herhaalde taken
Doen: Implementeer een lokale resultaatcache (bijvoorbeeld met sessionStorage of IndexedDB) voor herhaalde invoer of query's. Normaliseer de invoer door witruimte te verwijderen en kleine letters te gebruiken om het aantal hits in de cache te verhogen. Voor zware invoer, zoals afbeeldingen, genereer je een hash om te gebruiken als cachesleutel. Stel een conservatieve TTL (time to live) in voor je cache (of toon resultaten in de cache terwijl je ze op de achtergrond updatet). Laat de gebruiker een nieuwe inferentie activeren als het resultaat niet naar wens is.
Niet doen: Voer dezelfde inferentie niet opnieuw uit voor een herhaalde zoekopdracht of identieke gegevensinvoer waarbij variabiliteit niet wenselijk is, bijvoorbeeld als een gebruiker heen en weer navigeert tussen zoekresultaten. Dit optimaliseert de reactiesnelheid en het efficiënte gebruik van lokale rekenkracht.
// ✅ DO: Check a local cache before running inference
async function getAiResponse(userInput, forceRefresh = false) {
  // Normalize the query to increase cache hits
  const query = userInput.trim().toLowerCase();
  const cacheKey = `ai_results_${query}`;
  const TTL_MS = 3600000; // 1 hour conservative TTL

  if (!forceRefresh) {
    const itemStr = localStorage.getItem(cacheKey);
    if (itemStr) {
      const item = JSON.parse(itemStr);
      const now = Date.now();

      // Check if the item has expired
      if (now < item.expiry) {
        // Lightweight safety check before rendering
        if (isValid(item.value)) return item.value;
      } else {
        // Delete the stale entry if the TTL has passed
        localStorage.removeItem(cacheKey);
      }
    }
  }

  // Fallback: Run inference if no valid cache exists
  const session = await LanguageModel.create();
  const response = await session.prompt(userInput);

  // Store the result for future use (with an expiration)
  const cacheData = {
    value: response,
    expiry: Date.now() + TTL_MS
  };
  localStorage.setItem(cacheKey, JSON.stringify(cacheData));

  return response;
}